Задача
«Автобизнес.рф» привозит машины из Китая. Из Яндекс.Вордстата скачивается таблица поисковых запросов (семантическое ядро — список фраз, по которым люди ищут товар, вместе с частотностью). В сыром виде в ней сотни повторов и мусорных фраз, а разбирать её руками — долго. Нужен был свой инструмент, который делает два шага: очищает таблицу и раскладывает запросы по категориям.
Инструмент — это две отдельные программы на Python. Обе умеют работать с обычными файлами Excel (.xlsx), поэтому не требуют установки чего-то ещё на компьютер клиента. Программы делались под конкретную задачу «Автобизнес.рф», но подходят к любой таблице запросов.
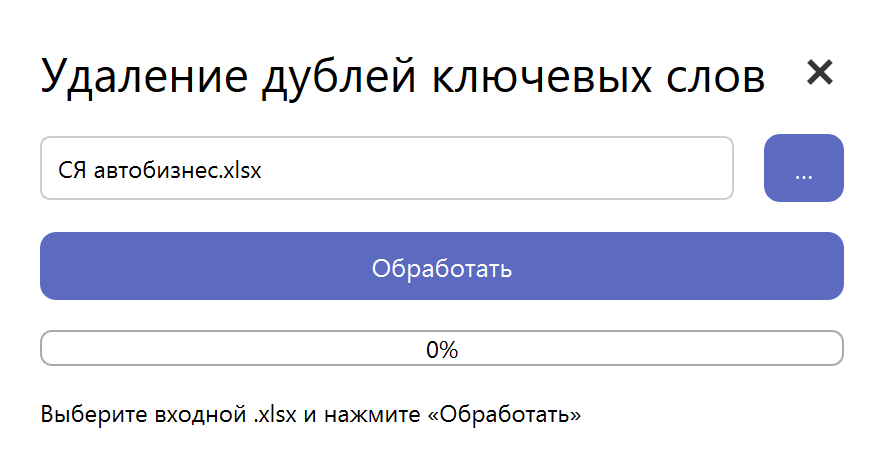
- Программа 1 — очистка. Десктопное окошко на PySide6 (библиотека для графических программ на Python). Берёт файл, убирает дубли и мусор, сохраняет новый файл.
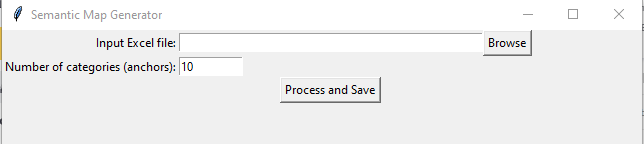
- Программа 2 — семантическая карта. Окошко на Tkinter (вторая библиотека для графических программ на Python). Раскладывает запросы по категориям и выгружает таблицу из двух колонок: «категория» и «запрос».
Что сделано
Две программы и проверка на реальных данных клиента.
Программа 1 · очистка дублей
ВыполненоОчистка таблицы от повторов и мусорных фраз
Что сделано
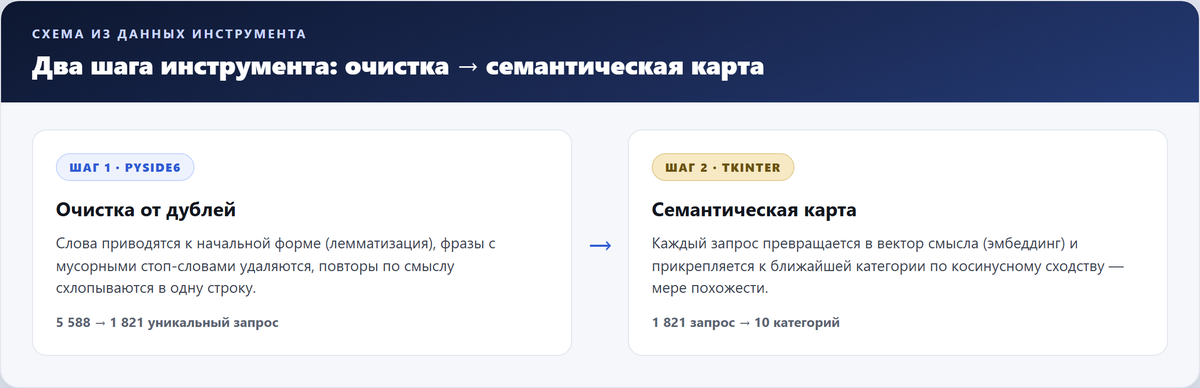
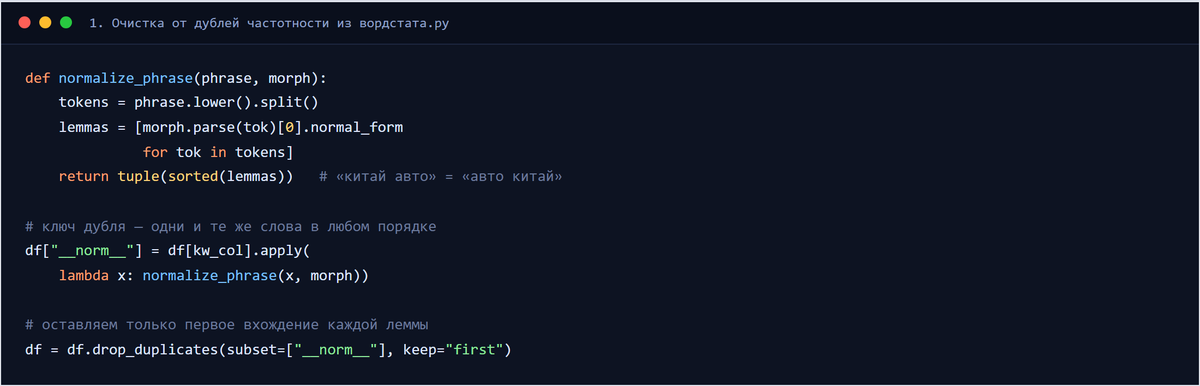
Слова приводятся к начальной форме — это лемматизация (например, «автомобилей», «автомобили» и «автомобиль» становятся одним словом «автомобиль»). Дальше слова сортируются, поэтому «китай авто» и «авто китай» дают одинаковый ключ, и повторы схлопываются в одну строку. Отдельно фразы проверяются по словарю стоп-слов (47 слов: фото, отзывы, телефон, рейтинг, секс, форум и подобные) — такие строки удаляются. Окошко сделано без стандартной рамки, со скруглёнными углами, его можно перетаскивать за заголовок; есть кнопка «Обработать», прогресс-бар и статус. Добавлена совместимость со старым кодом через небольшую заплатку (monkey-patch метода inspect.getargspec), чтобы библиотека разбора слов работала в новых версиях Python.
Результат
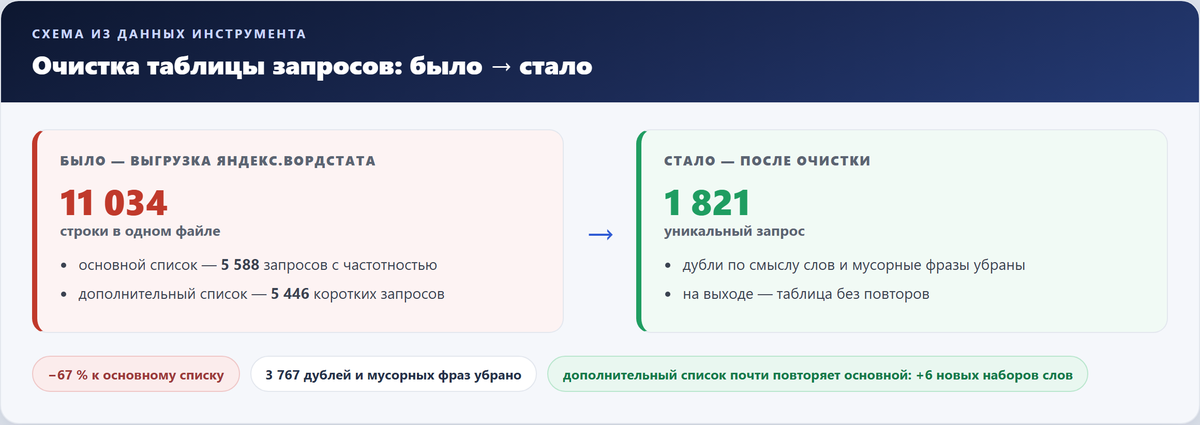
Основной список из 5 588 запросов сжался до 1 821 уникального — сокращение на 67 %, убрано 3 767 повторов и мусорных фраз. В том же файле был второй, дополнительный список на 5 446 коротких запросов; после приведения слов к начальной форме он почти полностью повторял основной и добавил всего 6 новых наборов слов. Итог по обоим спискам (11 034 строки) — те же 1 821 уникальных запроса.
Программа 2 · семантическая карта
ВыполненоРаскладка запросов по категориям
Что сделано
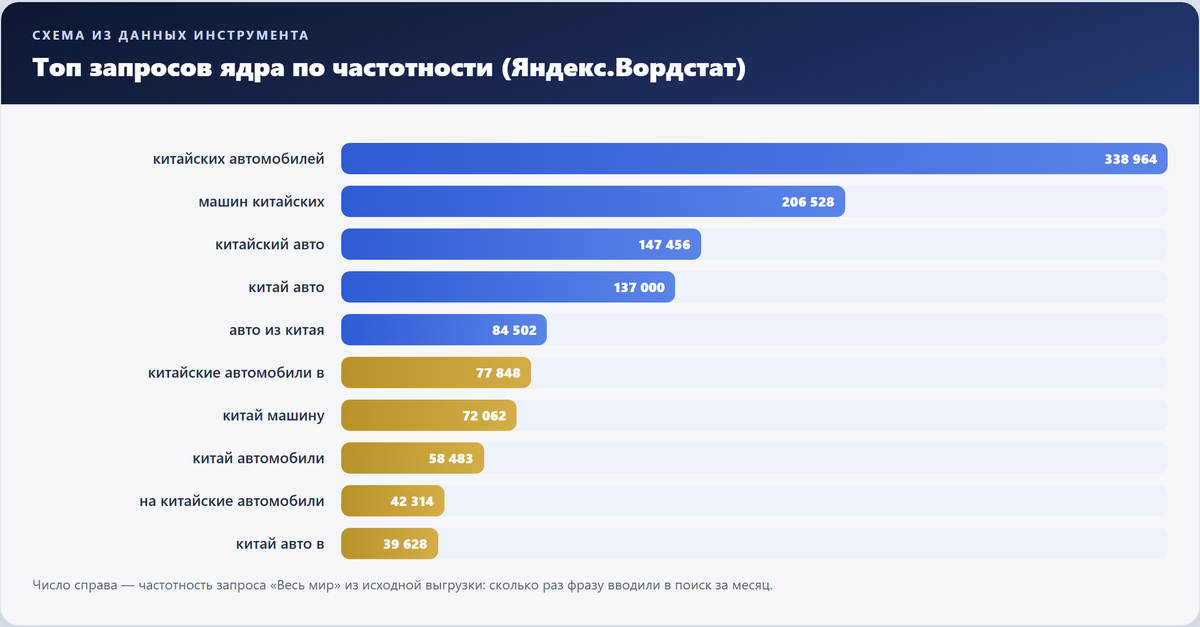
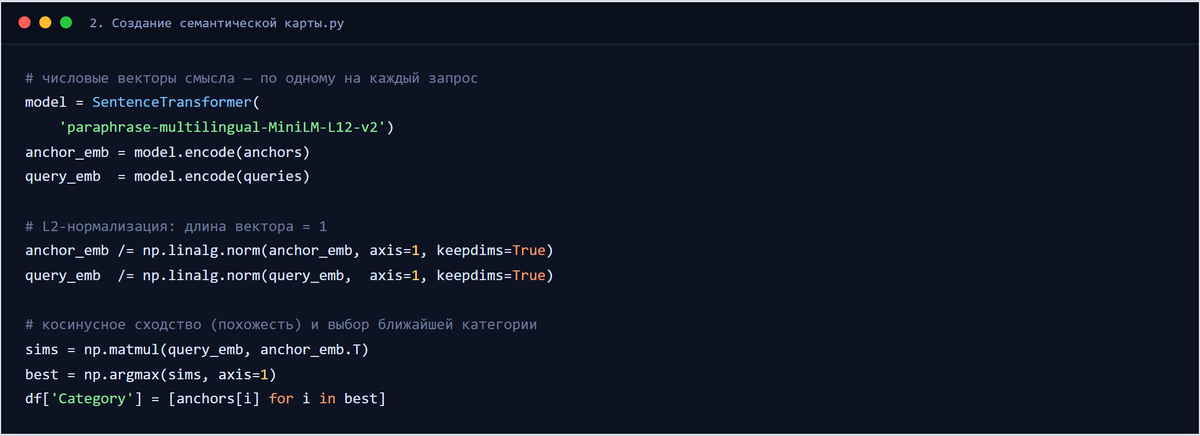
Программа берёт заданное число самых частотных запросов (по умолчанию 10) и делает их якорями-категориями. Затем каждый запрос превращается в эмбеддинг — числовой вектор смысла (модель Sentence Transformers paraphrase-multilingual-MiniLM-L12-v2 выдаёт вектор из 384 чисел). Векторы нормализуются по длине, дальше считается косинусное сходство (мера похожести между векторами) и каждый запрос прикрепляется к ближайшему якорю. На выходе — таблица из двух колонок: «Category» (категория) и «Query» (запрос).
Результат
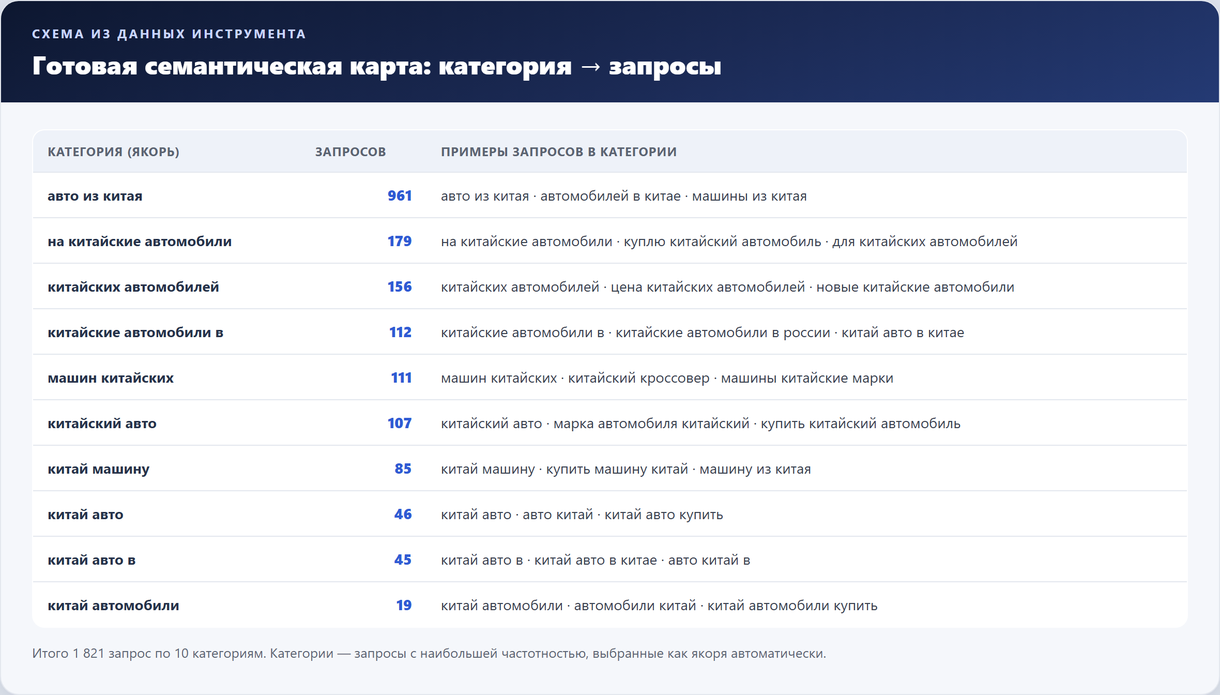
1 821 запрос разложен по 10 категориям. Самая крупная — «авто из китая» (961 запрос), далее «на китайские автомобили» (179), «китайских автомобилей» (156), «китайские автомобили в» (112). Файл ядро.xlsx содержит готовую таблицу «категория → запрос».
Проверка на данных клиента
ВыполненоЧисла сверены по файлам «Автобизнес.рф»
Что сделано
Цифры в этом кейсе пересчитаны прямо по содержимому xlsx-файлов: исходная выгрузка СЯ автобизнес.xlsx (два листа), результат очистки СЯ автобизнес_без_дублей.xlsx и семантическая карта ядро.xlsx. Поэтому данные по таблице и по категориям совпадают.
Результат
Оба файла результата содержат 1 821 строку данных (1 822 строки вместе с шапкой таблицы) и по категориям сходятся: 10 категорий, 1 821 запрос.
Этапы и сроки
- Разбор задачи — 1–2 дня. Смотрю формат вашей выгрузки и что считать мусором, предлагаю структуру категорий.
- План и смета — после разбора. Согласуем объём, фиксирую срок и цену.
- Сборка программ — по объёму: очистка от дублей и раскладка по категориям под вашу нишу.
- Проверка на ваших данных — прогоняю инструмент на реальном файле и сверяю числа до точного совпадения.
Сроки беру из реального проекта; по вашему случаю назову после бесплатного разбора.
Частые вопросы
Работает ли с моими данными?
Да, программы работают с обычными Excel-файлами (.xlsx) и настраиваются под любую таблицу поисковых запросов, а не только авто.
Куда уходит моя таблица?
Никуда: всё считается локально на вашем компьютере, данные не отправляются в сторонние сервисы.
Какой формат на выходе?
Готовая таблица из двух колонок: категория и запрос. Её можно открыть в Excel и сразу раздать по страницам сайта.
Что если у меня другая ниша?
Подойдёт: стоп-слова и категории настраиваются под ваш рынок. Покажу на вашем файле, что получится.
Сколько это займёт времени?
Зависит от объёма данных. Точный срок назову после бесплатного разбора вашей таблицы.