Проверка сайта для ИИ-поиска · 17.09.2026 · этап проверки, внедрения не было
abdu.kz: сайт веб-студии не видят ChatGPT, Claude и Яндекс Нейро — диагноз и план на 14 шагов
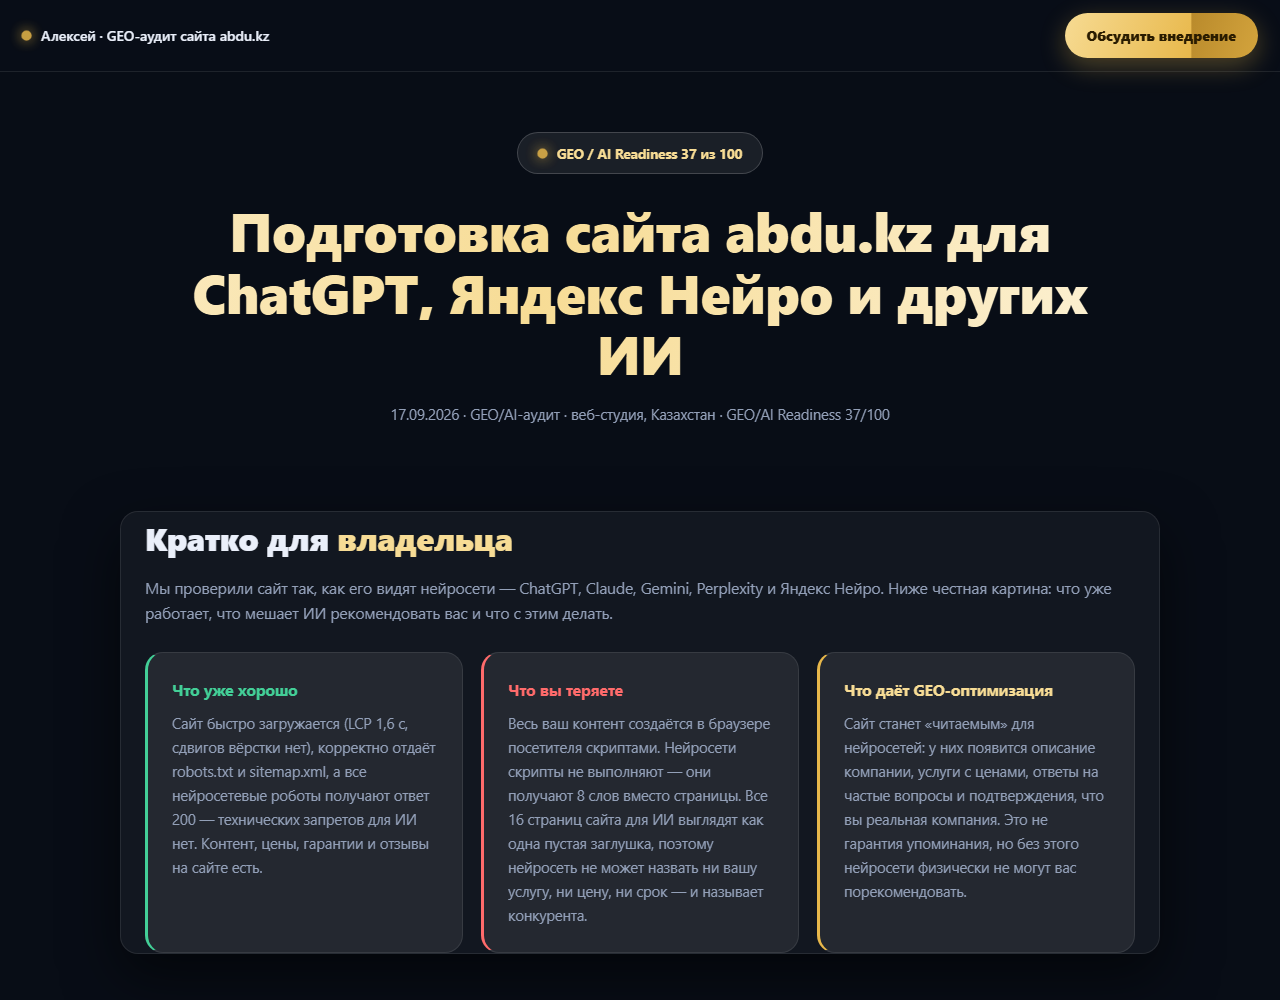
ChatGPT, Claude и Яндекс Нейро не видят контент этого сайта: робот получает 8 слов вместо 255 — 3 % содержимого. 15 из 16 страниц для робота недостижимы, цены и ответы спрятаны. Показываем, что именно теряется, и даём план из 14 задач с критериями приёмки.
Проверка для ИИ-поискаПопадание в ответы нейросетей (AEO)Текст сразу в коде страницыФайл llms.txtРазметка Schema.orgrobots.txt и карта сайтаСкорость сайтаПлан внедрения
Сайт:abdu.kzКлиент: владелец abdu.kz (название компании в исходных материалах не указано)Ниша: веб-студия / digital-агентство, АлматыПлатформа: сайт на скриптах (React, Vite) на Vercel, без текста сразу в кодеПериод: аудит 17.09.2026
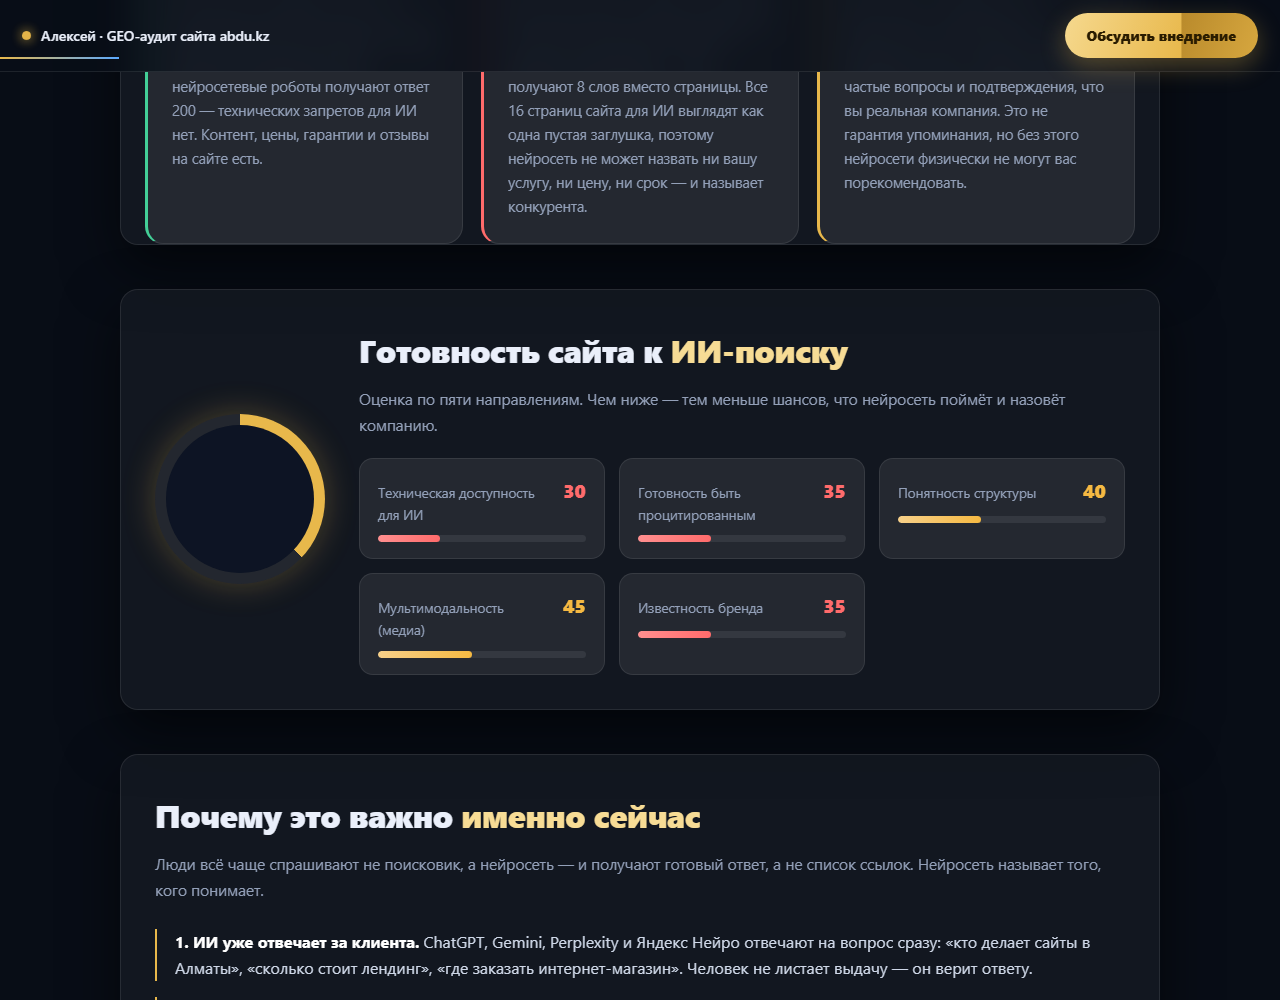
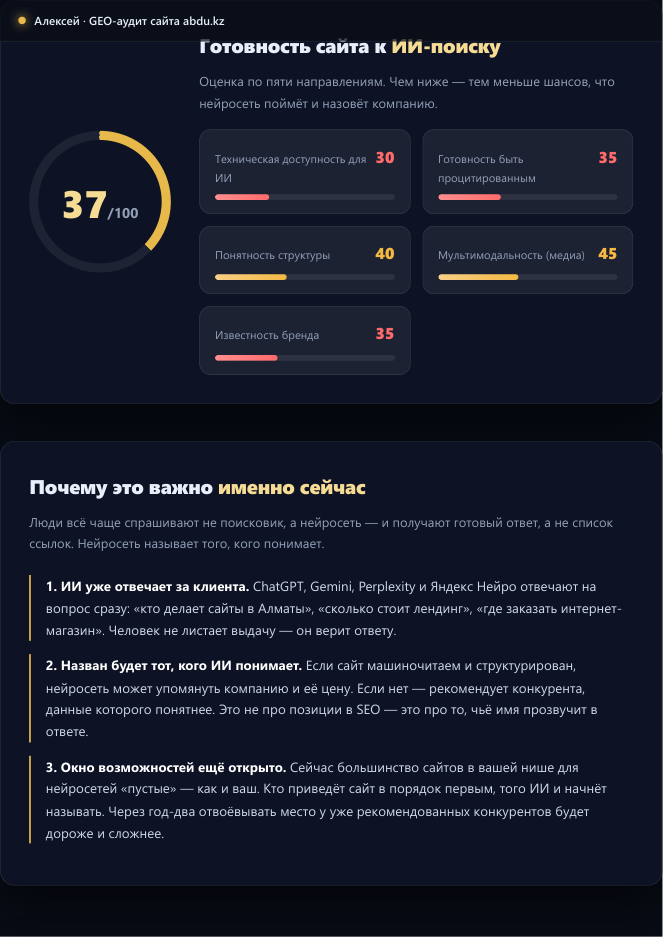
37 / 100
Оценка готовности сайта к ИИ — нейросети его почти не видят
техника 30 · цитируемость 35 · структура 40 · мультимедиа 45 · авторитет 35
8 слов
Получает робот вместо 255 — лишь 3 % контента
поэтому ChatGPT и Claude не назовут ваши услуги
15 из 16
Страниц недостижимы для робота — цены и услуги невидимы
в коде страницы до запуска скриптов ноль ссылок
0 из 5
Ответов на частые вопросы есть в коде — нейросеть их не прочитает
ответы спрятаны за кликом
1,6 с
Главная открывается быстро — это запас прочности
прорисовка страницы быстрая, сдвигов текста (CLS) 0 — плюс клиента
Что вы получите
Диагноз с доказательствами
Видите, что именно получают нейросети вместо ваших цен и отзывов, — с сохранёнными файлами под каждый вывод.
План на 14 шагов
Задачи с приоритетом Critical/High/Medium/Low и критерием приёмки по каждой — без расплывчатого «сделайте SEO».
Отчёт и письмо для разработчика
HTML/PDF-отчёт и письмо с разбором по пунктам: что теряется и что даёт исправление. Можно сразу отдать исполнителю.
Задача
Проверить, как сайт выглядит для ИИ-поиска: что получают ChatGPT, Claude, Gemini, Perplexity и Яндекс Нейро вместо страницы с услугами, ценами и отзывами. Итог этапа — аудит с цифрами, план внедрения и критерии приёмки по каждой задаче.
Объём проверки:
Адреса: главная плюс все 16 адресов из карты сайта (sitemap.xml). Для каждого — код страницы до запуска скриптов браузера.
Прорисовка страницы браузером: 10 адресов открыты в Chromium, чтобы сравнить, что получает робот и что видит человек.
Роботы нейросетей: настоящие запросы к серверу с подменой имени робота при запросе (User-Agent) — GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, PerplexityBot, Googlebot, Google-Extended, Yandexbot, CCBot, Bytespider, Amazonbot, Applebot-Extended.
Слои: robots.txt (файл с правилами для роботов), карта сайта, страницы-заглушки (soft-404), главный адрес страницы (canonical), hreflang, разметка (Schema.org — служебные блоки в коде, которые читают поисковики и нейросети), попадание в ответы нейросетей (AEO) и цитируемость, признаки надёжности сайта (E-E-A-T), заголовки безопасности, скорость сайта (Core Web Vitals).
Что получает клиент на этом этапе:
технический отчёт со списком артефактов — каждый вывод закрыт сохранённым кодом страницы, прорисовкой страницы браузером или ответом сервера;
клиентский отчёт в HTML и PDF: 12 секций, 12 проблем с разбором «в чём проблема → решение», 9 страниц PDF;
план внедрения из 14 задач с приоритетами, порядком работ и критерием приёмки по каждой задаче;
письмо с разбором по пунктам — что теряет сайт и что это даёт.
Ограничения, зафиксированные в отчёте: ключа оценки скорости от Google (PageSpeed) в окружении нет, поэтому скорость сайта (Core Web Vitals) снята замером в Chromium на компьютере без искусственно медленного интернета, а отклик на действия пользователя (INP) в таком замере не измеряется; выгрузок Google Search Console, Яндекс.Вебмастера и Метрики не было; проверить факт реального цитирования в ответах ChatGPT или Perplexity из окружения нельзя. Внедрение на этом этапе не проводилось.
Было — что нашли
Сайт работает и выглядит нормально. Проблема не в дизайне и не в скорости, а в том, что в исходном коде страницы контента почти нет.
Критично
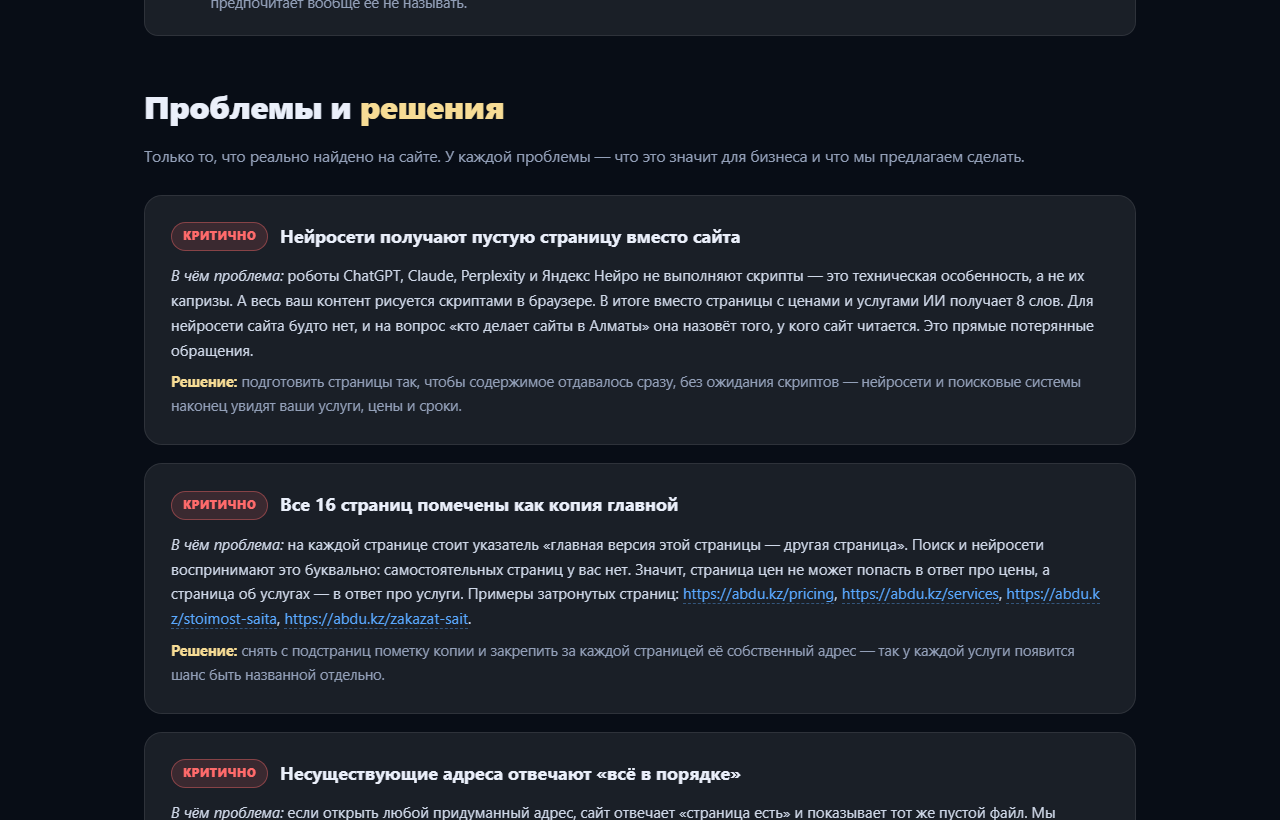
Сайт на скриптах без текста сразу в коде: робот получает 8 слов
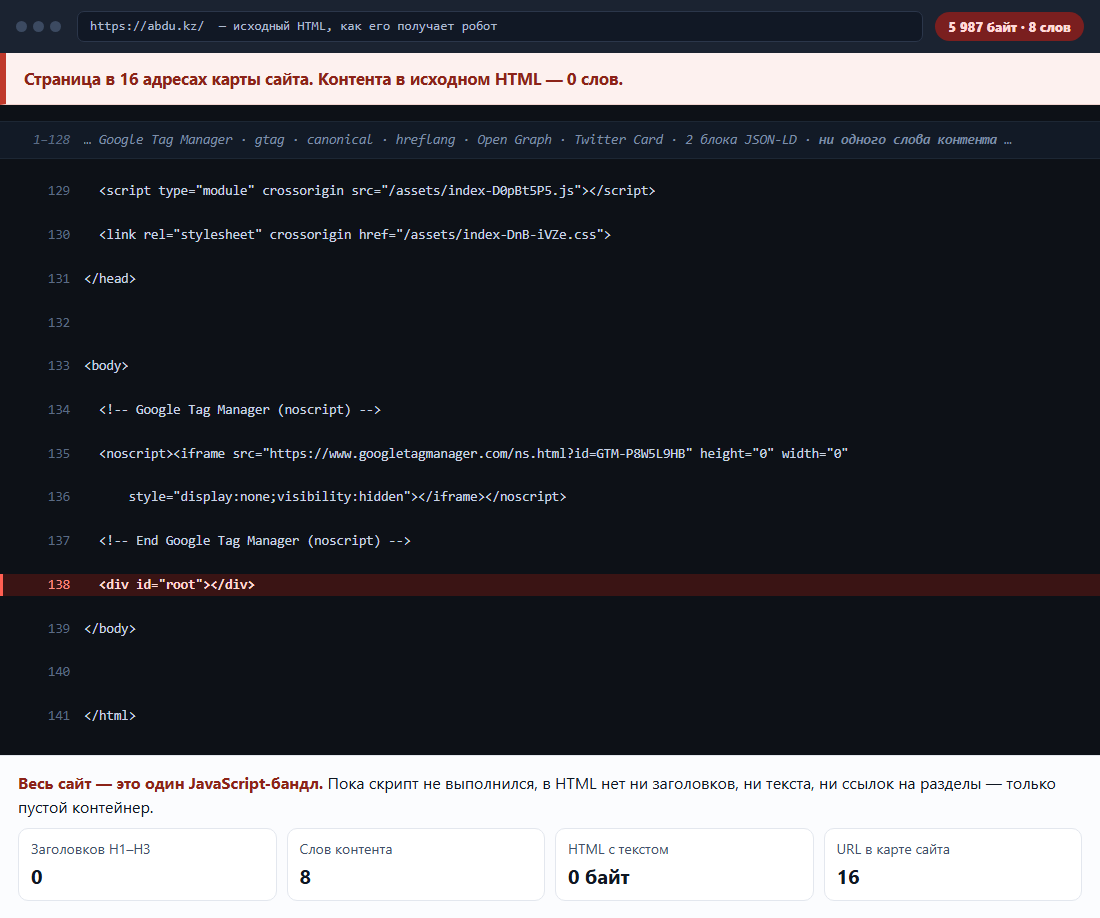
Код главной до запуска скриптов — 5 987 байт: пустой контейнер, ноль заголовков H1/H2/H3, ноль ссылок и картинок, 53 символа текста. После прорисовки страницы браузером — 255 слов. В исходном коде остаётся 3% контента. Так выглядят все 16 адресов сайта.
Критично
Все 16 страниц помечены как копия главной
Указатель главного адреса страницы (canonical) на главную стоит на каждом разделе и самим сайтом не переписывается: уникальных адресов один на 16 страниц. Отдельной страницы цен, услуг или интернет-магазина для поиска и для ИИ не существует.
Критично
Ответы на вопросы спрятаны за кликом
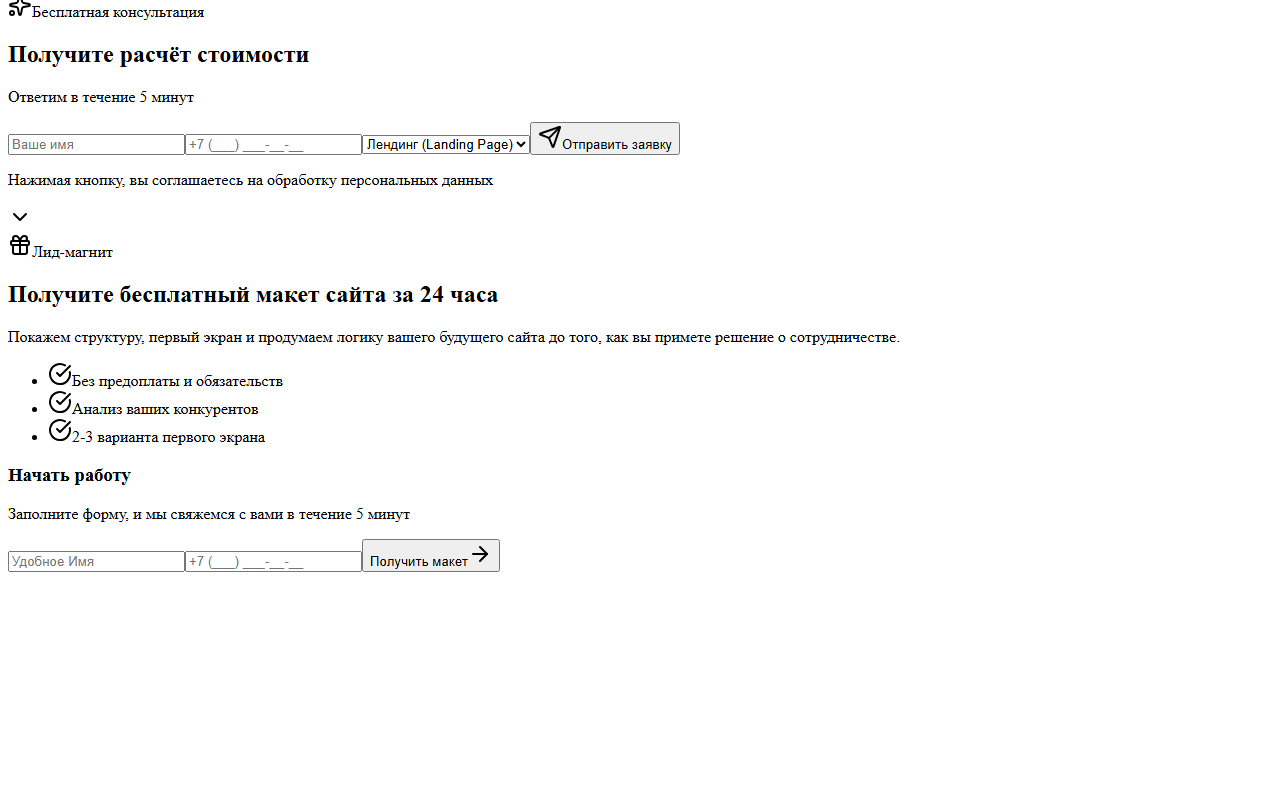
На странице стоимости пять частых вопросов существуют как кнопки с текстом вопроса. Ответы появляются только после клика, в коде страницы их нет. Ноль пар «вопрос — ответ»: нейросеть видит вопрос без ответа и не может его пересказать.
Критично
Мусорные адреса отвечают кодом 200 вместо 404
Файл llms.txt — короткая памятка для нейросетей, манифест агентов, два адреса карты сайта и случайный несуществующий путь отвечают кодом 200 и отдают пустую оболочку главной страницы. Поисковый робот не отличает мусор от страницы и может затянуть его в поисковую базу.
Высокая
Карта сайта из 16 адресов, 15 — «сироты»
Поисковый робот дошёл только до главной: в исходном коде страницы нет ни одной внутренней ссылки. Плюс устаревание — дата изменения старше 180 дней у 100% адресов, вердикт critical_decay. И два мусорных адреса карты сайта отдаются как HTML вместо XML.
Высокая
Файл llms.txt отдаётся как HTML, а не текст
По адресу файла-визитки для нейросетей приходит 200 с типом содержимого text/html и теми же 5 987 байтами пустой оболочки главной. Автоматическая проверка формально насчитала «файл существует» по коду 200, при этом заголовков ноль, markdown-ссылок ноль, оценка 20 из 100.
Высокая
Цены, сроки, рейтинг и отзывы не описаны так, чтобы их могли прочитать нейросети
На страницах есть цены от 70 000, 150 000 и 250 000 тенге, срок 3–5 дней, рейтинг 5.0 и четыре отзыва. В разметке только «Организация» и «профессиональные услуги» — без цены, отзывов, вопросов-ответов и логотипа. Цитируемых фактов: 0, внешних ссылок: 0.
Средняя
Цифры о компании расходятся между страницами
Главная: 8+ лет опыта, 50+ клиентов, 99% довольных. Страницы услуг: 10 лет, 150+ проектов, рейтинг 5.0. Нейросеть получает конфликтующие факты и в итоге не называет ни одну цифру.
Обманчиво
Сторонний SEO-скрипт показывает 96 из 100
Скрипт оценивает только служебные мета-данные — заголовок, описание, главный адрес страницы (canonical), robots — и пропускает скорость сайта (Core Web Vitals), потому что нет ключа оценки скорости от Google (PageSpeed). Главную проблему он не видит физически. В отчёте этот балл назван вводящим в заблуждение.
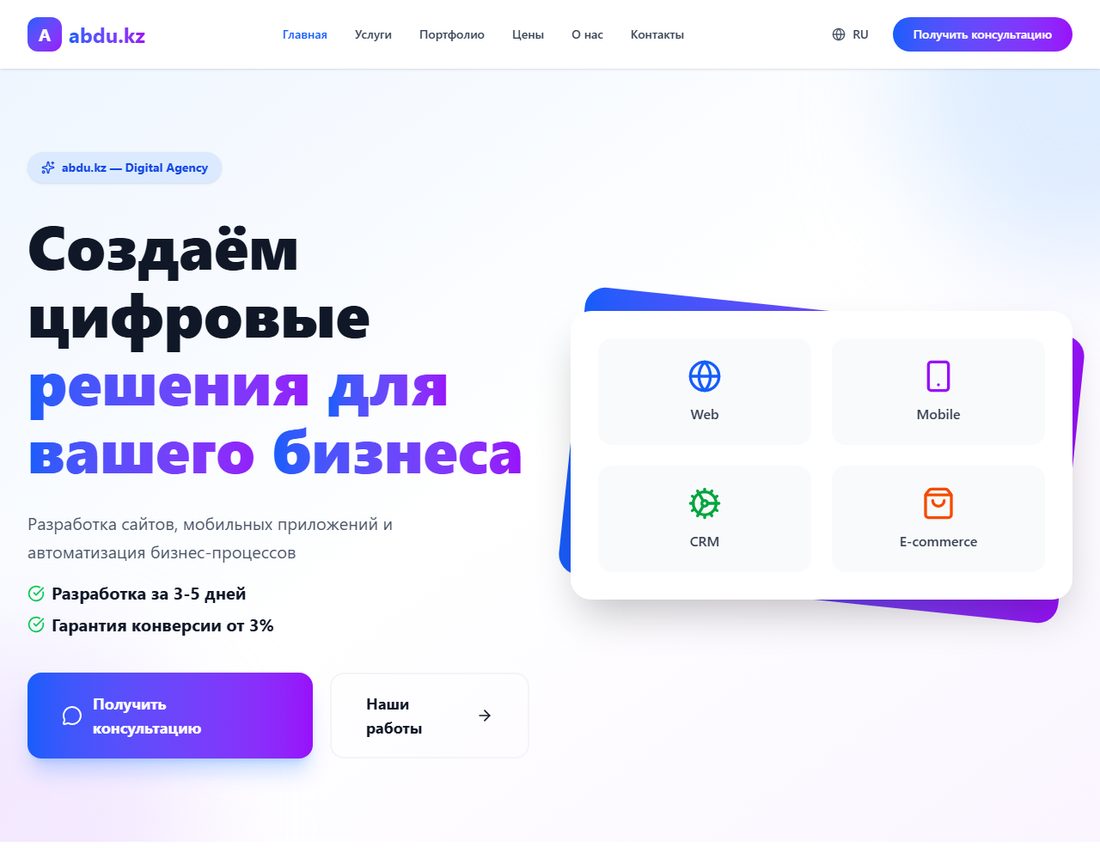
Что получает робот: 5 987 байт и всего 8 словЧто видит человек: те же 255 слов с ценами и отзывами
Это не «до и после работ», а два взгляда на один и тот же адрес: слева то, что получает робот, который не запускает скрипты, справа то, что видит человек в браузере. Разметка при этом не менялась — расходится только то, что успевает прорисоваться.
Что сделано
Работа на этом этапе — измерение и документирование. Каждый вывод закрыт артефактом, а не мнением. Ниже отдельно — план внедрения: он передан клиенту, но не выполнен.
Работа 1 · код страницы до запуска скриптов
Выполнено
Собрали ответ сервера по всем 16 адресам без запуска скриптов браузера
Что сделано
Для каждого адреса из карты сайта забрали исходный ответ и разобрали его тем же парсером, что и прорисованную версию. Результат одинаковый на всех 16: 5 987 байт, 8 слов, 0 заголовков H1/H2/H3, 0 абзацев, 0 ссылок, 0 картинок, один уникальный заголовок вкладки и один уникальный главный адрес страницы (canonical).
Результат
Получен артефакт, который нельзя оспорить: робот и человек получают разные страницы по одному и тому же адресу.
Работа 2 · прорисовка страницы браузером
Выполнено
Отрисовали ключевые страницы в Chromium и сравнили с исходником
Что сделано
Прорисовали в браузере 10 адресов: главную, разделы услуг, кейсов, цен, о компании, контакты, отдельную страницу под один оффер, страницу заказа и страницу стоимости, а также несуществующий /design как пример страницы-заглушки (soft-404). Считали заголовки, число слов, заголовок вкладки и внутренние ссылки до и после прорисовки.
Результат
Контент на сайте есть, он просто не в исходном коде страницы: главная — 255 слов и 4 подзаголовка, /pricing — 348 слов, /stoimost-saita — 834 слова, /zakazat-sait — 863 слова. Уникальный заголовок вкладки только у двух адресов из десяти, остальные отдают заголовок главной. Несуществующий /design после прорисовки даёт 51 слово и ни одного H1 — то есть это действительно пустышка, а не страница.
Работа 3 · доступ роботов
Выполнено
Проверили, кого сайт пускает и что именно отдаёт
Что сделано
Настоящие запросы к серверу с подменой имени робота при запросе (User-Agent) для тринадцати поисковых и обучающих роботов. Проверили robots.txt (файл с правилами для роботов), цепочку перенаправлений (0 хопов, 666 мс), заголовок X-Robots-Tag, матрицу попадания в поисковую базу и файлы, которые запрашивают системы кроме Google.
Результат
Ни один робот нейросети не заблокирован: все отвечают кодом 200, защитного экрана Cloudflare (WAF) нет, сервер — Vercel. Проблема не в доступе, а в том, что робот получает по разрешению: почти пустой документ.
Работа 4 · слои проверки
Выполнено
Прогнали автоматические проверки технической части и содержимого
Что сделано
robots.txt — файл с правилами для роботов (127 байт, директива карты сайта закомментирована), карта сайта (16 адресов, дата изменения есть у всех), страницы-заглушки вместо ошибки 404 прямыми запросами, главный адрес страницы (canonical), hreflang, разметка (Schema.org — служебные блоки в коде, которые читают поисковики и нейросети: 0 ошибок, 5 предупреждений), попадание в ответы нейросетей (AEO и готовность давать прямой ответ, оценка 0), готовность быть процитированным (оценка 35, фактов 0), признаки надёжности сайта (E-E-A-T), заголовки безопасности (45 из 100), скорость сайта (Core Web Vitals) замером в браузере: главная картинка (LCP) 1,62 с, первый экран (FCP) 0,89 с, сдвиги текста (CLS) 0, передача скриптов 173 КБ.
Результат
Картина по всем слоям с цифрами и ссылками на артефакты. Заодно зафиксировали, что четыре тега языка ru / kk / en / x-default указывают на главную: языковых версий на сайте нет, а заявлять их нельзя.
Работа 5 · отчёт и письмо
Выполнено
Собрали отчёт и письмо с разбором
Что сделано
Клиентский отчёт в HTML и PDF: 12 секций, 12 проблем в формате «в чём проблема — решение», два блока призыва к действию, 9 страниц PDF. Отдельно технический отчёт и план внедрения. Письмо — с пятью находками по пунктам, что теряет сайт и что даёт исправление.
Результат
Клиент получает не оценку, а список из 14 задач с приоритетом и критерием приёмки по каждой. В письме и отчёте прямо сказано: гарантировать упоминание в ответах нейросетей нельзя, ИИ сам решает, кого называть.
План · Critical 4
Только план
Что нужно сделать, чтобы сайт начали читать
Задачи
C1. Готовить ключевые страницы заранее на сервере: отдавать код с контентом до загрузки скриптов.
C2. Убрать общий главный адрес страницы (canonical) на главную, поставить свой на каждый раздел.
C3. Настоящий 404 для несуществующих адресов вместо ответа 200 с главной.
C4. Положить ответы FAQ в код страницы, а не показывать по клику.
Критерий приёмки
В исходном HTML каждой ключевой страницы не меньше 300 слов, ровно один H1, внутри — цены и ответы FAQ. Проверка canonical показывает свой адрес на всех 16 страницах, а несуществующий адрес отдаёт 404.
План · High 5
Только план
Файлы для ИИ, разметка и цитируемые факты
Задачи
H1. Настоящий llms.txt вместо HTML-заглушки: текстовый тип содержимого, заголовок, описание и ссылки на разделы.
H2. Рабочая директива карты сайта в robots.txt и явное разделение поисковых и обучающих ботов.
H3. Связанный блок разметки: организация с логотипом, сайт, страница, услуги с ценами, вопрос-ответ, хлебные крошки, рейтинг.
H4. Свести к одному набору годы опыта, число проектов и клиентов, рейтинг и сроки.
H5. Ответ на главный вопрос страницы в первых строках плюс самодостаточный абзац на 134–167 слов с цифрами и внешними ссылками.
Критерий приёмки
Файл llms.txt отдаётся как текст с заголовком и ссылками, robots.txt содержит рабочую директиву карты сайта, валидатор разметки даёт 0 ошибок и находит цены и вопрос-ответ, а оценка answer-first выше нуля.
План · Medium 3
Только план
Карта сайта, языки и даты
Задачи
M1. Починить языковые теги: сделать реальные версии или убрать их, пока четыре языка не указывают на главную.
M2. Добавить видимые даты публикации и обновления, ссылку на профиль автора и честное обновление дат в карте сайта.
M3. Убрать мусорные адреса карты сайта и закрыть «сироты» (страницы, на которые никто не ссылается) — после подготовки страниц на сервере и появления ссылок в коде они станут достижимы.
Критерий приёмки
Проверка «сирот» показывает 0, вердикт по устареванию карты сайта больше не critical_decay, а страница не содержит нескольких языковых тегов на один адрес.
План · Low 2
Только план
Заголовки безопасности и манифест агентов
Задачи
L1. Дописать заголовки безопасности: сейчас только HSTS без поддоменов, оценка 45 из 100 — нет политики содержимого, защиты от подделки типа, защиты от кликджекинга, политики ссылок и разрешений.
L2. Манифест агентов создавать только при наличии рабочего API для чтения. Если API нет — честный 404 вместо фиктивного файла.
Критерий приёмки
Оценка заголовков безопасности выше 80 из 100; манифест агентов либо отдаётся как валидный JSON со ссылками на существующие операции, либо честно отвечает 404.
Этапы и сроки
Разбор сайта — 1 день. Запрашиваю страницы как робот нейросети и смотрю код страницы до запуска скриптов.
Отчёт, план и письмо — 1–2 дня. Баллы по 5 направлениям, таблица доступа роботов и 14 задач с критериями приёмки.
Согласование объёма — 1–2 дня. Выбираете, что внедрять и в каком порядке; называю вилку цены.
Внедрение и повторная проверка — по объёму. После правок повторяю те же проверки и сравниваю с исходными.
Сроки беру из реального проекта; по вашему сайту назову после бесплатного разбора.
Стало — результат
Внедрения не было: ни одна из 14 задач не выполнена, поэтому замеров «после» в кейсе нет. Результат этапа — поставленный диагноз, доказательная база и план, по которому внедрение можно проверить и принять.
Что зафиксировано
Оценка готовности к ИИ-поиску по пяти направлениям: технический доступ 30, готовность быть процитированным 35, читаемость структуры 40, мультимедиа 45, известность бренда 35 — итого 37 из 100.
Главное препятствие с приоритетом P1: в коде главной до запуска скриптов 8 слов против 255 после прорисовки страницы браузером, то есть 3% контента, и это состояние одинаково на всех 16 адресах.
Двенадцать проблем в отчёте, каждая в связке «в чём проблема — решение», плюс план из 14 задач с приоритетами и критериями приёмки.
Один показатель назван вводящим в заблуждение: скрипт стороннего SEO-разбора выдал 96 из 100, потому что проверяет только служебные мета-данные и не видит сайт на скриптах без текста сразу в коде.
Критерий приёмки всего плана
не меньше 300 слов в исходном коде каждой ключевой страницы, один H1, цены и ответы на вопросы — внутри разметки;
свой главный адрес страницы (canonical) на всех 16 адресах вместо одного на главную;
несуществующие адреса отдают 404, а не страницу с кодом 200;
в robots.txt (файл с правилами для роботов) рабочая директива карты сайта, llms.txt — короткая памятка для нейросетей — отдаётся как текст с заголовком и ссылками;
проверка разметки даёт 0 ошибок, цены, отзывы и вопрос-ответ описаны в разметке;
на страницах стоит ответ на главный вопрос в первых строках, а цифры о компании совпадают между главной и страницами услуг.
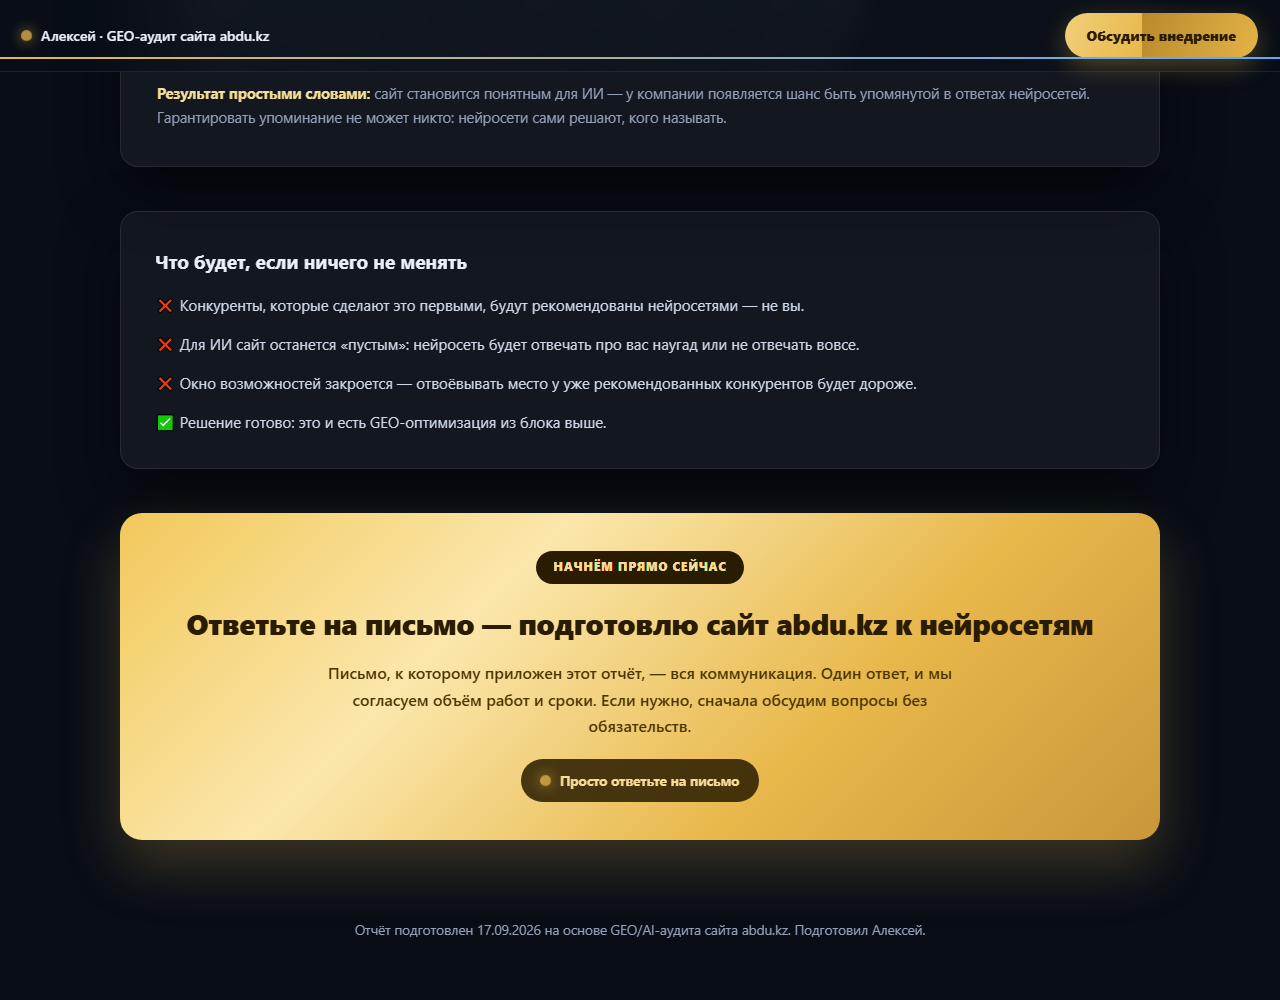
Отдельно зафиксировано в отчёте и в письме клиенту: llms.txt не влияет на Google и на ответы с ИИ-обзорами — это дешёвая страховка для Perplexity, Claude и самописных агентов, а не фактор ранжирования. И гарантировать появление сайта в ответах нейросетей не может никто: ИИ сам решает, кого назвать.
Результат «до / после»
Параметр
До
После (план)
Слова в коде главной до запуска скриптов
8
от 300 по критерию приёмки C1
Заголовки H1 / H2 / H3 в коде страницы
0 / 0 / 0
ровно 1 H1 плюс иерархия подзаголовков
Уникальные главные адреса (canonical) на 16 адресах
1 — главная у всех
16 — свой адрес у каждого
Адреса карты сайта, доступные поисковому роботу
1 из 16
16 из 16
Несуществующий адрес
200 и шелл главной
404 со своей страницей ошибки
Файл llms.txt для нейросетей
200, HTML, 5 987 байт, оценка 20/100
текст с заголовком, описанием и ссылками на разделы
прямой ответ в первых строках плюс абзац с цифрами и ссылками
Цифры о компании
8 лет и 50 клиентов против 10 лет и 150 проектов
один набор цифр на главной и на страницах услуг
Языковые теги
ru, kk, en, x-default — все на главную
реальные языковые версии или теги убраны
Устаревание карты сайта
critical_decay, 100% адресов старше 180 дней
вердикт не critical_decay, даты обновляются при правках
Заголовки безопасности
45 из 100, только HSTS
выше 80 из 100
Готовность к ИИ-поиску
37 из 100
переоценка после внедрения, без обещанного балла
Внедрения не было. Все значения в колонке «После (план)» взяты из критериев приёмки плана внедрения, а не из замеров после работ: подставить сюда цифры «после» было бы выдумкой. Отдельно стоит держать в голове расхождение двух оценок одного сайта — 37 из 100 по оценке готовности к ИИ и 96 из 100 по стороннему SEO-скрипту: вторую в отчёте названо вводящей в заблуждение, потому что она проверяет только мета-слой.
Пруфы
Скриншоты двух типов: прорисованные в браузере сохранённые выгрузки кода сайта, снятые во время проверки, и скриншоты приложенного клиентского отчёта. Кадров «после работ» нет — внедрение не проводилось. Кликните, чтобы открыть в полном размере.
Что видит человек: цены и отзывы на странице стоимостиТак начинается отчёт: балл 37 из 100 в первом экранеРазбор по направлениям: где именно сайт проседает для ИИКаждая проблема — рядом с решением, без общих словПро цену бездействия прямо: что теряется, если не менятьОтчёт в PDF — удобно переслать разработчику или партнёру
Сколько стоит
Проверка и план
Бесплатно: показываю на вашем сайте, что теряют нейросети, и даю список задач. Формат — отчёт с баллами, план с критериями приёмки и письмо с разбором.
Внедрение под ключ
Стоимость считаю после разбора — зависит от объёма правок и платформы сайта. Точную вилку называю до начала.
Цены не публикую: они зависят от задачи. Оставьте заявку — пришлю вилку под ваш случай в тот же день.
Частые вопросы
А если после правок нейросеть всё равно не назовёт мой сайт? Гарантировать это нельзя: ИИ сам решает, кого цитировать. Но убрать причины, по которым вас не видят, можно — это и делаем.
Нужен ли доступ к админке? Для разбора нет — работаю снаружи. Для внедрения может понадобиться доступ к движку сайта; способ выбираем под вашу платформу.
Сколько это стоит и от чего зависит цена? Проверка и план — бесплатно. Цена внедрения зависит от числа правок и технологии сайта; вилку называю до старта.
Чем это отличается от обычного SEO-аудита? Обычный аудит проверяет выдачу. Здесь — что получают ChatGPT, Claude и Яндекс Нейро и почему вас нет в их ответах.
Проверю, читают ли ваш сайт нейросети
Тот же разбор: код страницы до запуска скриптов против того, что собрал браузер, ответы сервера роботам ИИ-поиска, карта сайта, разметка и готовность быть процитированным. На выходе — план задач с приоритетом и критерием приёмки по каждой. Гарантировать появление сайта в ответах нейросетей нельзя: нейросеть сама решает, кого назвать.