GEO / AI-аудит · 17.09.2026 · этап аудита, внедрения не было
abdu.kz: сайт с ценами, сроками и отзывами, которых не видят ChatGPT, Claude и Яндекс Нейро
Аудит сайта веб-студии из Казахстана: главная плюс 16 URL из карты сайта, GEO / AI Readiness — 37 из 100. Главный блокер — React SPA без SSR: сырой HTML главной весит 5 987 байт и содержит 8 слов против 255 слов после рендера, то есть 3% контента. Дальше — 15 из 16 страниц, до которых не доходит краулер, soft-200 вместо 404, FAQ без ответов в коде и план внедрения из 14 задач. Внедрения на этом этапе не было: кейс показывает аудит, план и критерии приёмки.
GEO / AI-аудитAEOSSR / пре-рендерllms.txtSchema.org / JSON-LDrobots.txt и sitemapCore Web VitalsПлан внедрения
Сайт:abdu.kzКлиент: владелец abdu.kz (название компании в исходных материалах не указано)Ниша: веб-студия / digital-агентство, АлматыПлатформа: React SPA (Vite) на Vercel, без SSRПериод: аудит 17.09.2026
37 / 100
GEO / AI Readiness на 17.09.2026
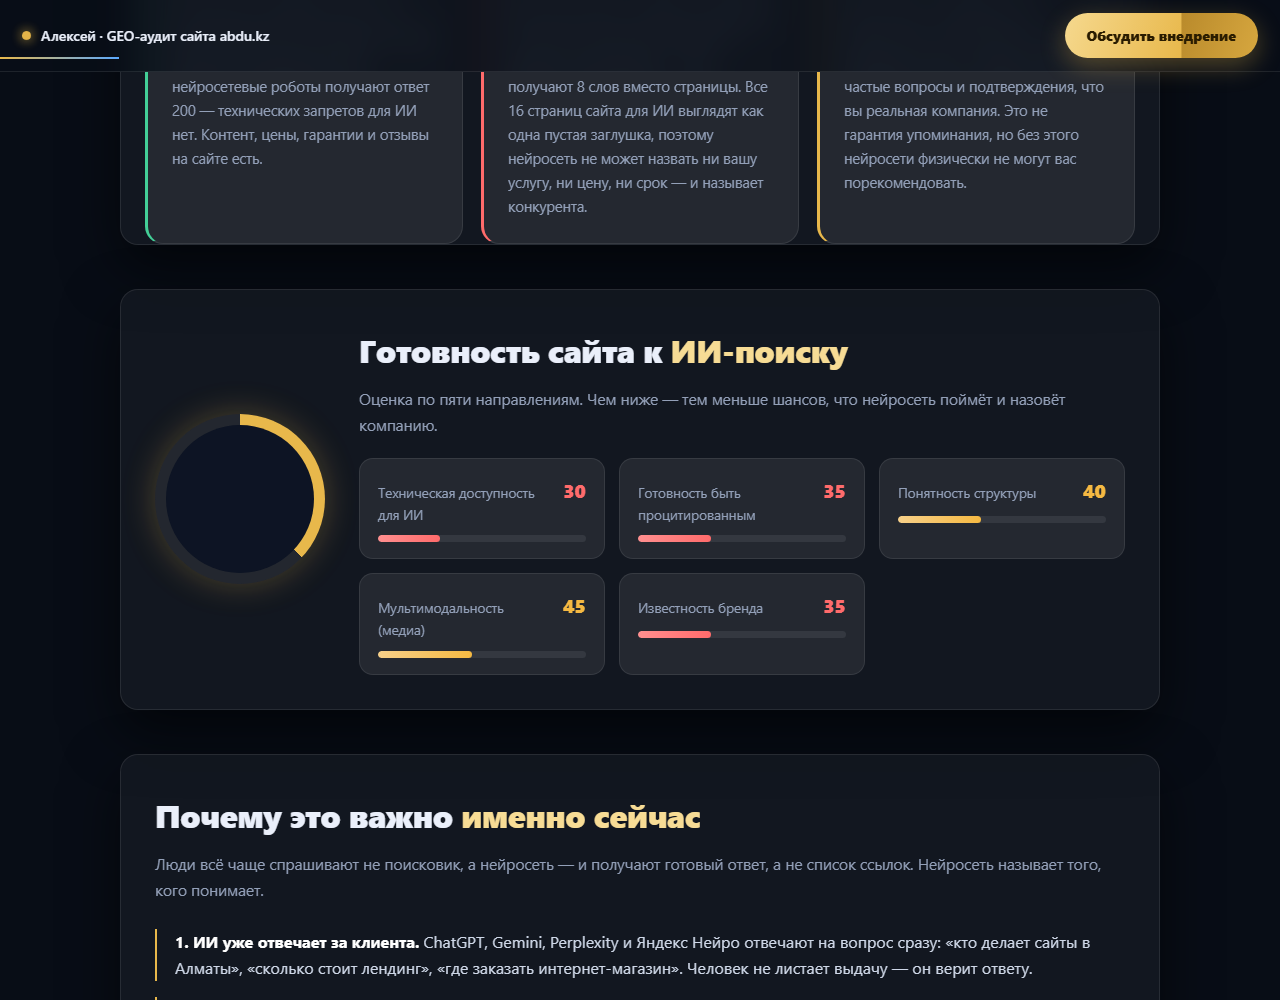
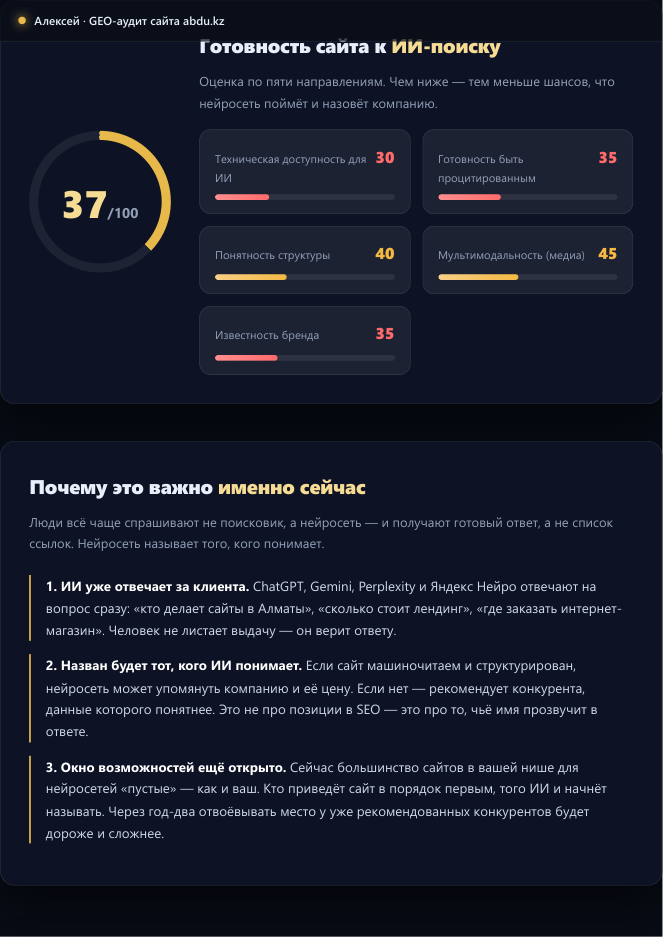
техника 30 · цитируемость 35 · структура 40 · мультимедиа 45 · авторитет 35
8 слов
текста в сыром HTML главной
3% от 255 слов, которые видит человек
15 из 16
страниц карты сайта недостижимы краулером
в сыром HTML ноль внутренних ссылок
14 задач
план внедрения с критериями приёмки
Critical 4 · High 5 · Medium 3 · Low 2 · не выполнено
1,6 с
LCP главной, lab-замер в Chromium
рендер быстрый, CLS 0 — это плюс клиента
Задача
Проверить, как сайт выглядит для ИИ-поиска: что получают ChatGPT, Claude, Gemini, Perplexity и Яндекс Нейро вместо страницы с услугами, ценами и отзывами. Итог этапа — аудит с цифрами, план внедрения и критерии приёмки по каждой задаче.
Объём проверки:
Адреса: главная плюс все 16 URL из sitemap.xml. Для каждого — сырой HTML без выполнения JavaScript.
Рендер: 10 адресов отрисованы в Chromium, чтобы сравнить, что получает робот и что видит человек.
Слои: robots.txt, карта сайта, soft-404, canonical, hreflang, Schema.org, AEO и цитируемость, E-E-A-T, заголовки безопасности, Core Web Vitals.
Что получает клиент на этом этапе:
технический отчёт с индексами артефактов — каждый вывод закрыт сохранённым сырым HTML, рендером или ответом сервера;
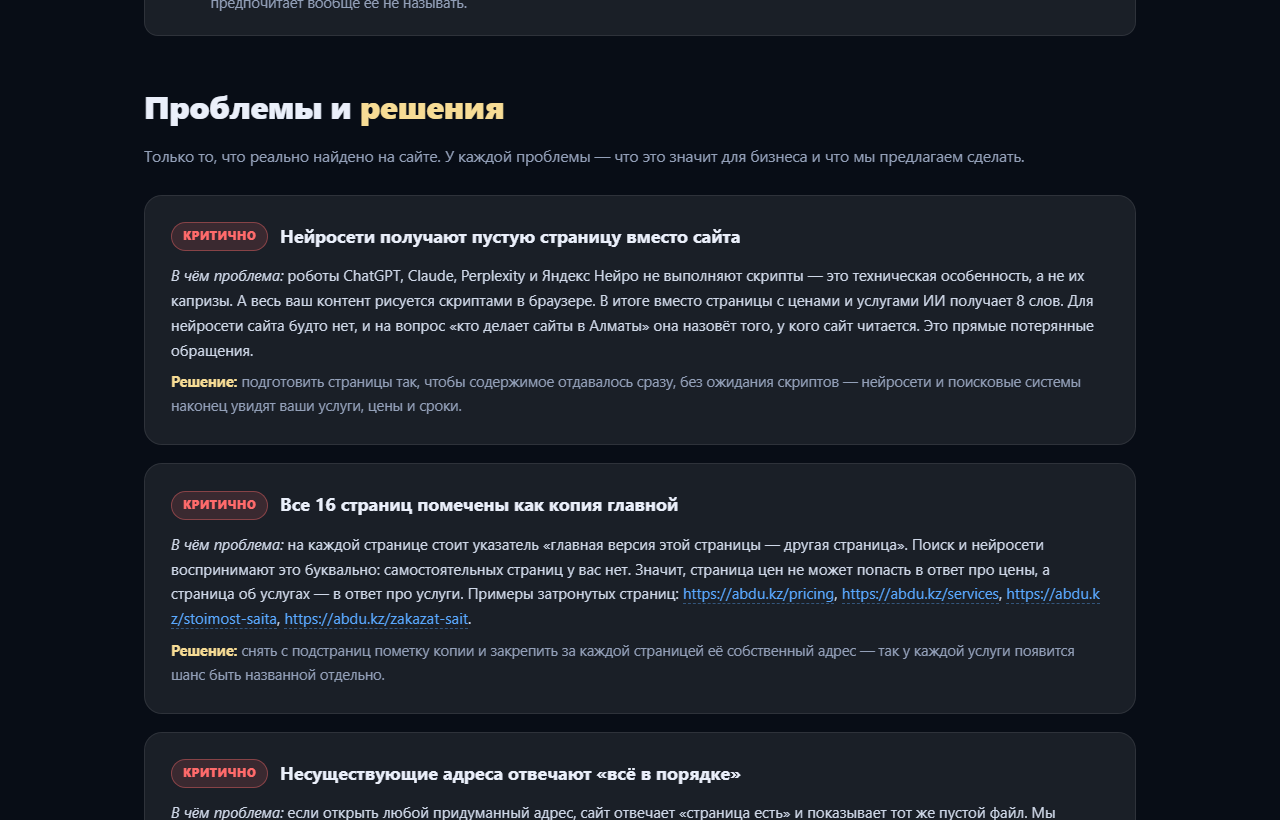
клиентский отчёт в HTML и PDF: 12 секций, 12 проблем с разбором «в чём проблема → решение», 9 страниц PDF;
план внедрения из 14 задач с приоритетами, порядком работ и критерием приёмки по каждой задаче;
письмо с разбором по пунктам — что теряет сайт и что это даёт.
Ограничения, зафиксированные в отчёте: ключа PageSpeed в окружении нет, поэтому Core Web Vitals сняты lab-методом в Chromium на десктопе без троттлинга, а INP в lab не измеряется; выгрузок Google Search Console, Яндекс.Вебмастера и Метрики не было; проверить факт реального цитирования в ответах ChatGPT или Perplexity из окружения нельзя. Внедрение на этом этапе не проводилось.
Было — что нашли
Сайт работает и выглядит нормально. Проблема не в дизайне и не в скорости, а в том, что в исходном HTML контента почти нет.
Критично
React SPA без SSR: робот получает 8 слов
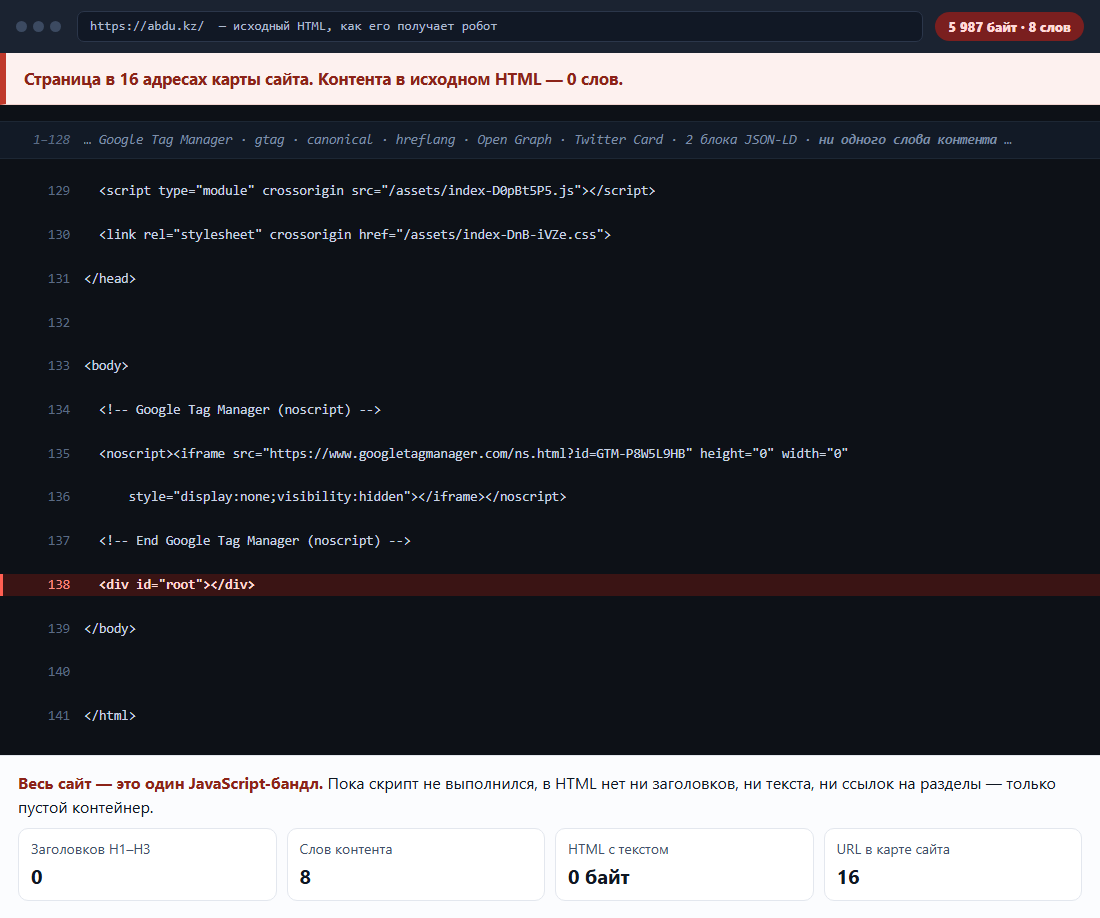
Сырой HTML главной — 5 987 байт: пустой контейнер, ноль H1/H2/H3, ноль ссылок и картинок, 53 символа текста. После рендера — 255 слов. В исходном HTML остаётся 3% контента. Так выглядят все 16 адресов сайта.
Критично
Все 16 страниц помечены как копия главной
Указатель canonical на главную стоит на каждом маршруте и роутером не переписывается: уникальных canonical один на 16 страниц. Отдельной страницы цен, услуг или интернет-магазина для поиска и для ИИ не существует.
Критично
Ответы на вопросы спрятаны за кликом
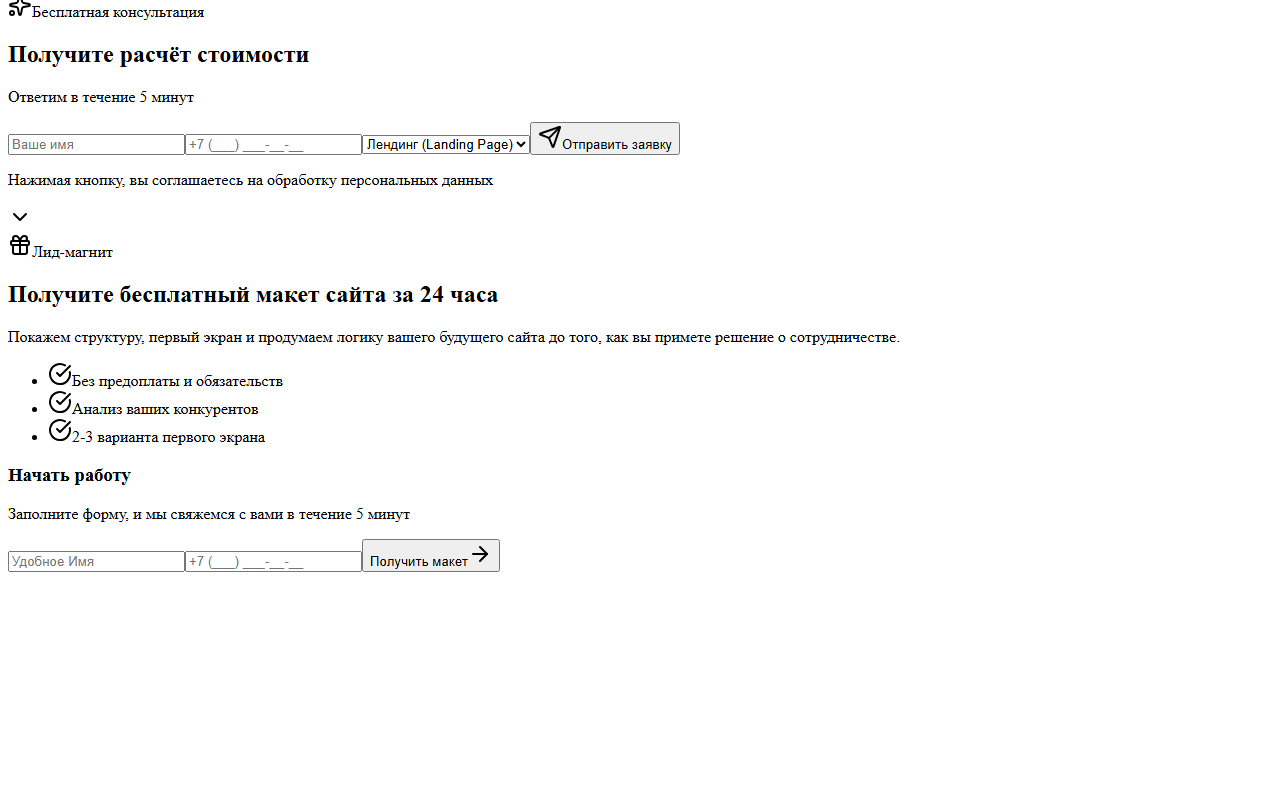
На странице стоимости пять частых вопросов существуют как кнопки с текстом вопроса. Ответы появляются только после клика, в коде страницы их нет. Ноль пар «вопрос — ответ»: нейросеть видит вопрос без ответа и не может его пересказать.
Критично
Мусорные адреса отвечают 200 вместо 404
Файл llms.txt, манифест агентов, два адреса карты сайта и случайный несуществующий путь отвечают кодом 200 и отдают шелл главной страницы. Краулер не отличает мусор от страницы и может затянуть его в индекс.
Высокая
Карта сайта из 16 адресов, 15 — «сироты»
Краулер дошёл только до главной: в исходном HTML нет ни одной внутренней ссылки. Плюс устаревание — дата изменения старше 180 дней у 100% адресов, вердикт critical_decay. И два мусорных адреса карты сайта отдаются как HTML вместо XML.
Высокая
Файл llms.txt отдаётся как HTML
По адресу файла-визитки для языковых моделей приходит 200 с типом содержимого text/html и теми же 5 987 байтами шелла главной. Чекер формально насчитал «файл существует» по коду 200, при этом заголовков ноль, markdown-ссылок ноль, оценка 20 из 100.
Высокая
Цены, сроки, рейтинг и отзывы не описаны машиночитаемо
На страницах есть цены от 70 000, 150 000 и 250 000 тенге, срок 3–5 дней, рейтинг 5.0 и четыре отзыва. В разметке только Organization и ProfessionalService — без цены, отзывов, FAQ и логотипа. Цитируемых фактов: 0, внешних ссылок: 0.
Средняя
Цифры о компании расходятся между страницами
Главная: 8+ лет опыта, 50+ клиентов, 99% довольных. Страницы услуг: 10 лет, 150+ проектов, рейтинг 5.0. Нейросеть получает конфликтующие факты и в итоге не называет ни одну цифру.
Обманчиво
Сторонний SEO-скрипт показывает 96 из 100
Скрипт оценивает только мета-слой — заголовок, описание, canonical, robots — и пропускает Core Web Vitals, потому что нет ключа PageSpeed. Главную проблему он не видит физически. В отчёте этот балл назван вводящим в заблуждение.
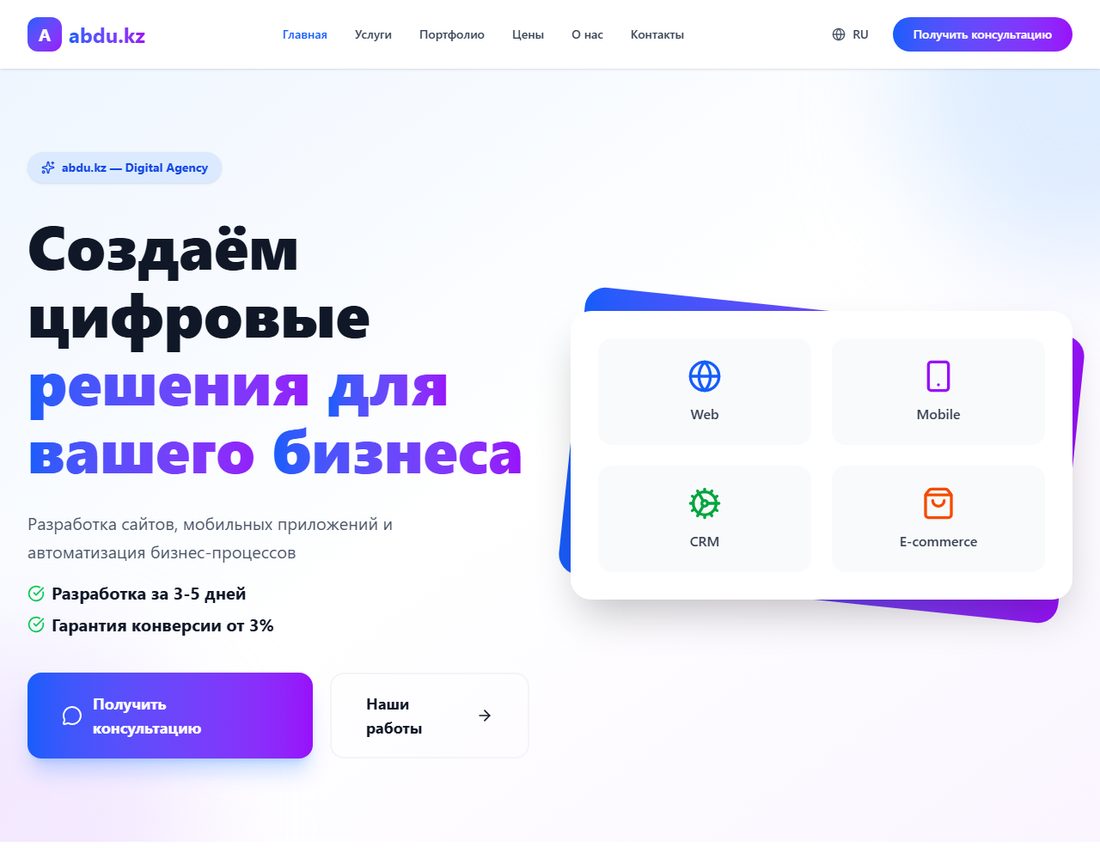
Робот — сырой HTML: 5 987 байт, 8 словЧеловек — тот же URL после рендера, 255 слов
Это не «до и после работ», а два взгляда на один и тот же URL: слева то, что получает робот, который не запускает скрипты, справа то, что видит человек в браузере. Разметка при этом не менялась — расходится только то, что успевает отрисоваться.
Что сделано
Работа на этом этапе — измерение и документирование. Каждый вывод закрыт артефактом, а не мнением. Ниже отдельно — план внедрения: он передан клиенту, но не выполнен.
Работа 1 · сырой HTML
Выполнено
Собрали ответ сервера по всем 16 адресам без выполнения JavaScript
Что сделано
Для каждого адреса из карты сайта забрали исходный ответ и разобрали его тем же парсером, что и отрендеренную версию. Результат одинаковый на всех 16: 5 987 байт, 8 слов, 0 заголовков H1/H2/H3, 0 абзацев, 0 ссылок, 0 картинок, один уникальный заголовок вкладки и один уникальный canonical.
Результат
Получен артефакт, который нельзя оспорить: робот и человек получают разные страницы по одному и тому же адресу.
Работа 2 · рендер
Выполнено
Отрисовали ключевые страницы в Chromium и сравнили с исходником
Что сделано
Отрендерили 10 адресов: главную, разделы услуг, кейсов, цен, о компании, контакты, лендинг, страницу заказа и страницу стоимости, а также несуществующий /design как пример soft-404. Считали заголовки, число слов, заголовок вкладки и внутренние ссылки до и после рендера.
Результат
Контент на сайте есть, он просто не в исходном HTML: главная — 255 слов и 4 подзаголовка, /pricing — 348 слов, /stoimost-saita — 834 слова, /zakazat-sait — 863 слова. Уникальный заголовок вкладки только у двух адресов из десяти, остальные отдают заголовок главной. Несуществующий /design после рендера даёт 51 слово и ни одного H1 — то есть это действительно пустышка, а не страница.
Работа 3 · доступ краулеров
Выполнено
Проверили, кого сайт пускает и что именно отдаёт
Что сделано
Фактические запросы к серверу с подменой User-Agent для тринадцати поисковых и обучающих ботов. Проверили robots.txt, цепочку редиректов (0 хопов, 666 мс), заголовок X-Robots-Tag, матрицу индексируемости и файлы, которые запрашивают не-Google системы.
Результат
Ни один ИИ-робот не заблокирован: все отвечают 200, WAF и Cloudflare нет, сервер — Vercel. Проблема не в доступе, а в том, что робот получает по разрешению: почти пустой документ.
Работа 4 · слои GEO
Выполнено
Прогнали технические и контентные чекеры
Что сделано
robots.txt (127 байт, директива карты сайта закомментирована), карта сайта (16 адресов, дата изменения есть у всех), soft-404 прямыми запросами, canonical, hreflang, Schema.org (0 ошибок, 5 предупреждений), AEO и answer-readiness (оценка 0), готовность к цитированию (оценка 35, фактов 0), E-E-A-T, заголовки безопасности (45 из 100), Core Web Vitals lab-методом: LCP 1,62 с, FCP 0,89 с, CLS 0, передача JavaScript 173 КБ.
Результат
Картина по всем слоям с цифрами и ссылками на артефакты. Заодно зафиксировали, что четыре тега языка ru / kk / en / x-default указывают на главную: языковых версий на сайте нет, а заявлять их нельзя.
Работа 5 · отчёт и письмо
Выполнено
Собрали отчёт и письмо с разбором
Что сделано
Клиентский отчёт в HTML и PDF: 12 секций, 12 проблем в формате «в чём проблема — решение», два блока призыва к действию, 9 страниц PDF. Отдельно технический отчёт и план внедрения. Письмо — с пятью находками по пунктам, что теряет сайт и что даёт исправление.
Результат
Клиент получает не оценку, а список из 14 задач с приоритетом и критерием приёмки по каждой. В письме и отчёте прямо сказано: гарантировать упоминание в ответах нейросетей нельзя, ИИ сам решает, кого называть.
План · Critical 4
Только план
Что нужно сделать, чтобы сайт начали читать
Задачи
C1. Пре-рендер ключевых страниц: отдавать HTML с контентом до загрузки скриптов.
C2. Убрать общий canonical на главную, поставить свой на каждый маршрут.
C3. Настоящий 404 для несуществующих адресов вместо ответа 200 с главной.
C4. Положить ответы FAQ в код страницы, а не показывать по клику.
Критерий приёмки
В исходном HTML каждой ключевой страницы не меньше 300 слов, ровно один H1, внутри — цены и ответы FAQ. Проверка canonical показывает свой адрес на всех 16 страницах, а несуществующий адрес отдаёт 404.
План · High 5
Только план
Файлы для ИИ, разметка и цитируемые факты
Задачи
H1. Настоящий llms.txt вместо HTML-заглушки: текстовый тип содержимого, заголовок, описание и ссылки на разделы.
H2. Рабочая директива карты сайта в robots.txt и явное разделение поисковых и обучающих ботов.
H3. Связанный граф разметки: организация с логотипом, сайт, страница, услуги с ценами, вопрос-ответ, хлебные крошки, рейтинг.
H4. Свести к одному набору годы опыта, число проектов и клиентов, рейтинг и сроки.
H5. Ответ на главный вопрос страницы в первых строках плюс самодостаточный абзац на 134–167 слов с цифрами и внешними ссылками.
Критерий приёмки
Файл llms.txt отдаётся как текст с заголовком и ссылками, robots.txt содержит рабочую директиву карты сайта, валидатор разметки даёт 0 ошибок и находит цены и вопрос-ответ, а оценка answer-first выше нуля.
План · Medium 3
Только план
Карта сайта, языки и даты
Задачи
M1. Починить языковые теги: сделать реальные версии или убрать их, пока четыре языка не указывают на главную.
M2. Добавить видимые даты публикации и обновления, ссылку на профиль автора и честное обновление дат в карте сайта.
M3. Убрать мусорные адреса карты сайта и закрыть «сирот» — после пре-рендера и появления ссылок в HTML они станут достижимы.
Критерий приёмки
Проверка «сирот» показывает 0, вердикт по устареванию карты сайта больше не critical_decay, а страница не содержит нескольких языковых тегов на один адрес.
План · Low 2
Только план
Заголовки безопасности и манифест агентов
Задачи
L1. Дописать заголовки безопасности: сейчас только HSTS без поддоменов, оценка 45 из 100 — нет политики содержимого, защиты от подделки типа, защиты от кликджекинга, политики ссылок и разрешений.
L2. Манифест агентов создавать только при наличии рабочего API для чтения. Если API нет — честный 404 вместо фиктивного файла.
Критерий приёмки
Оценка заголовков безопасности выше 80 из 100; манифест агентов либо отдаётся как валидный JSON со ссылками на существующие операции, либо честно отвечает 404.
Стало — результат
Внедрения не было: ни одна из 14 задач не выполнена, поэтому замеров «после» в кейсе нет. Результат этапа — поставленный диагноз, доказательная база и план, по которому внедрение можно проверить и принять.
Что зафиксировано
Оценка готовности к ИИ-поиску по пяти осям: технический доступ 30, готовность быть процитированным 35, читаемость структуры 40, мультимедиа 45, известность бренда 35 — итого 37 из 100.
Главный блокер с приоритетом P1: в исходном HTML главной 8 слов против 255 после рендера, то есть 3% контента, и это состояние одинаково на всех 16 адресах.
Двенадцать проблем в отчёте, каждая в связке «в чём проблема — решение», плюс план из 14 задач с приоритетами и критериями приёмки.
Один показатель назван вводящим в заблуждение: скрипт стороннего SEO-аудита выдал 96 из 100, потому что проверяет только мета-слой и не видит SPA без серверного рендера.
Критерий приёмки всего плана
не меньше 300 слов в исходном HTML каждой ключевой страницы, один H1, цены и ответы FAQ — внутри разметки;
свой canonical на всех 16 адресах вместо одного на главную;
несуществующие адреса отдают 404, а не страницу с кодом 200;
в robots.txt рабочая директива карты сайта, llms.txt отдаётся как текст с заголовком и ссылками;
валидатор разметки даёт 0 ошибок, цены, отзывы и вопрос-ответ описаны в разметке;
на страницах стоит ответ на главный вопрос в первых строках, а цифры о компании совпадают между главной и страницами услуг.
Отдельно зафиксировано в отчёте и в письме клиенту: llms.txt не влияет на Google и на ответы с ИИ-обзорами — это дешёвая страховка для Perplexity, Claude и самописных агентов, а не фактор ранжирования. И гарантировать появление сайта в ответах нейросетей не может никто: ИИ сам решает, кого назвать.
Результат «до / после»
Параметр
До
После (план)
Слова в исходном HTML главной
8
от 300 по критерию приёмки C1
Заголовки H1 / H2 / H3 в исходном HTML
0 / 0 / 0
ровно 1 H1 плюс иерархия подзаголовков
Уникальные canonical на 16 адресах
1 — главная у всех
16 — свой адрес у каждого
Адреса карты сайта, достижимые краулером
1 из 16
16 из 16
Несуществующий адрес
200 и шелл главной
404 со своей страницей ошибки
Файл llms.txt для ИИ
200, HTML, 5 987 байт, оценка 20/100
текст с заголовком, описанием и ссылками на разделы
прямой ответ в первых строках плюс абзац с цифрами и ссылками
Цифры о компании
8 лет и 50 клиентов против 10 лет и 150 проектов
один набор цифр на главной и на страницах услуг
Языковые теги
ru, kk, en, x-default — все на главную
реальные языковые версии или теги убраны
Устаревание карты сайта
critical_decay, 100% адресов старше 180 дней
вердикт не critical_decay, даты обновляются при правках
Заголовки безопасности
45 из 100, только HSTS
выше 80 из 100
Готовность к ИИ-поиску
37 из 100
переоценка после внедрения, без обещанного балла
Внедрения не было. Все значения в колонке «После (план)» взяты из критериев приёмки плана внедрения, а не из замеров после работ: подставить сюда цифры «после» было бы выдумкой. Отдельно стоит держать в голове расхождение двух оценок одного сайта — 37 из 100 по GEO / AI Readiness и 96 из 100 по стороннему SEO-скрипту: вторую в отчёте названо вводящей в заблуждение, потому что она проверяет только мета-слой.
Пруфы
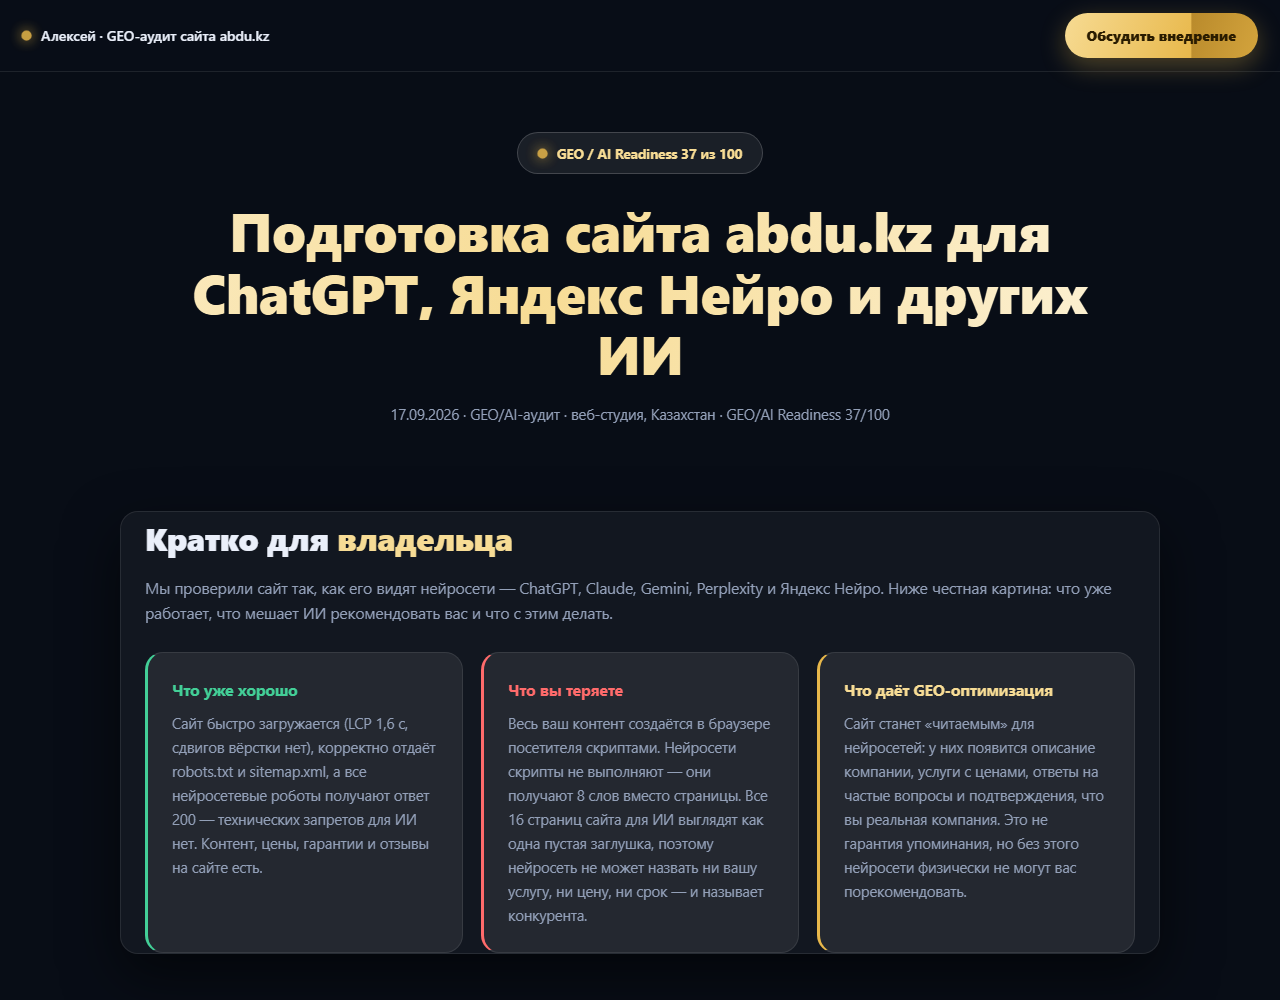
Скриншоты двух типов: рендеры сохранённых HTML-выгрузок сайта, снятые во время аудита, и скриншоты приложенного клиенского отчёта. Кадров «после работ» нет — внедрение не проводилось. Кликните, чтобы открыть в полном размере.
Рендер: /stoimost-saita после выполнения JSОтчёт: первый экранОтчёт: скоринг по пяти осямОтчёт: проблемы и решенияОтчёт: цена бездействия и призывОтчёт: версия в PDF